Светящаяся облако газа шириной в 100 миллиардов миль

Это драматическая картина получена Хабблом в туманности М1-67, вокруг звезды WR124, где находится светящеется облако газа размером в 100 миллиардов миль в поперечнике. Эти светящиеся капли газа расположены в 15000 световых лет от Земли, в созвездии Стрельца. По массе одна капля составляет около 30 масс Земли.
WR124 окружен горячим скоплением газа, который выбрасывается в пространство со скоростью более 100,000 миль в час без какой-либо общей глобальной структуры или оболочки. Массивная, горячая центральная звезда Вольфа-Райе, принадлежащая крайне редкому классу супер-горячей звезды, живет недолго и сейчас переживает бурный, переходный этап, характеризующийся ожесточенным выбросом масс вещества. Капли могут возникать из-за яростного звездного ветра, который прерывист и не плавный. В результате неустойчивостей это делает капли такими массивными. Капли со временем охлаждаются и в конечном итоге они рассеиваются в пространство, не представляя никакой угрозы для соседних звезд.
Центр галактики Центавр А
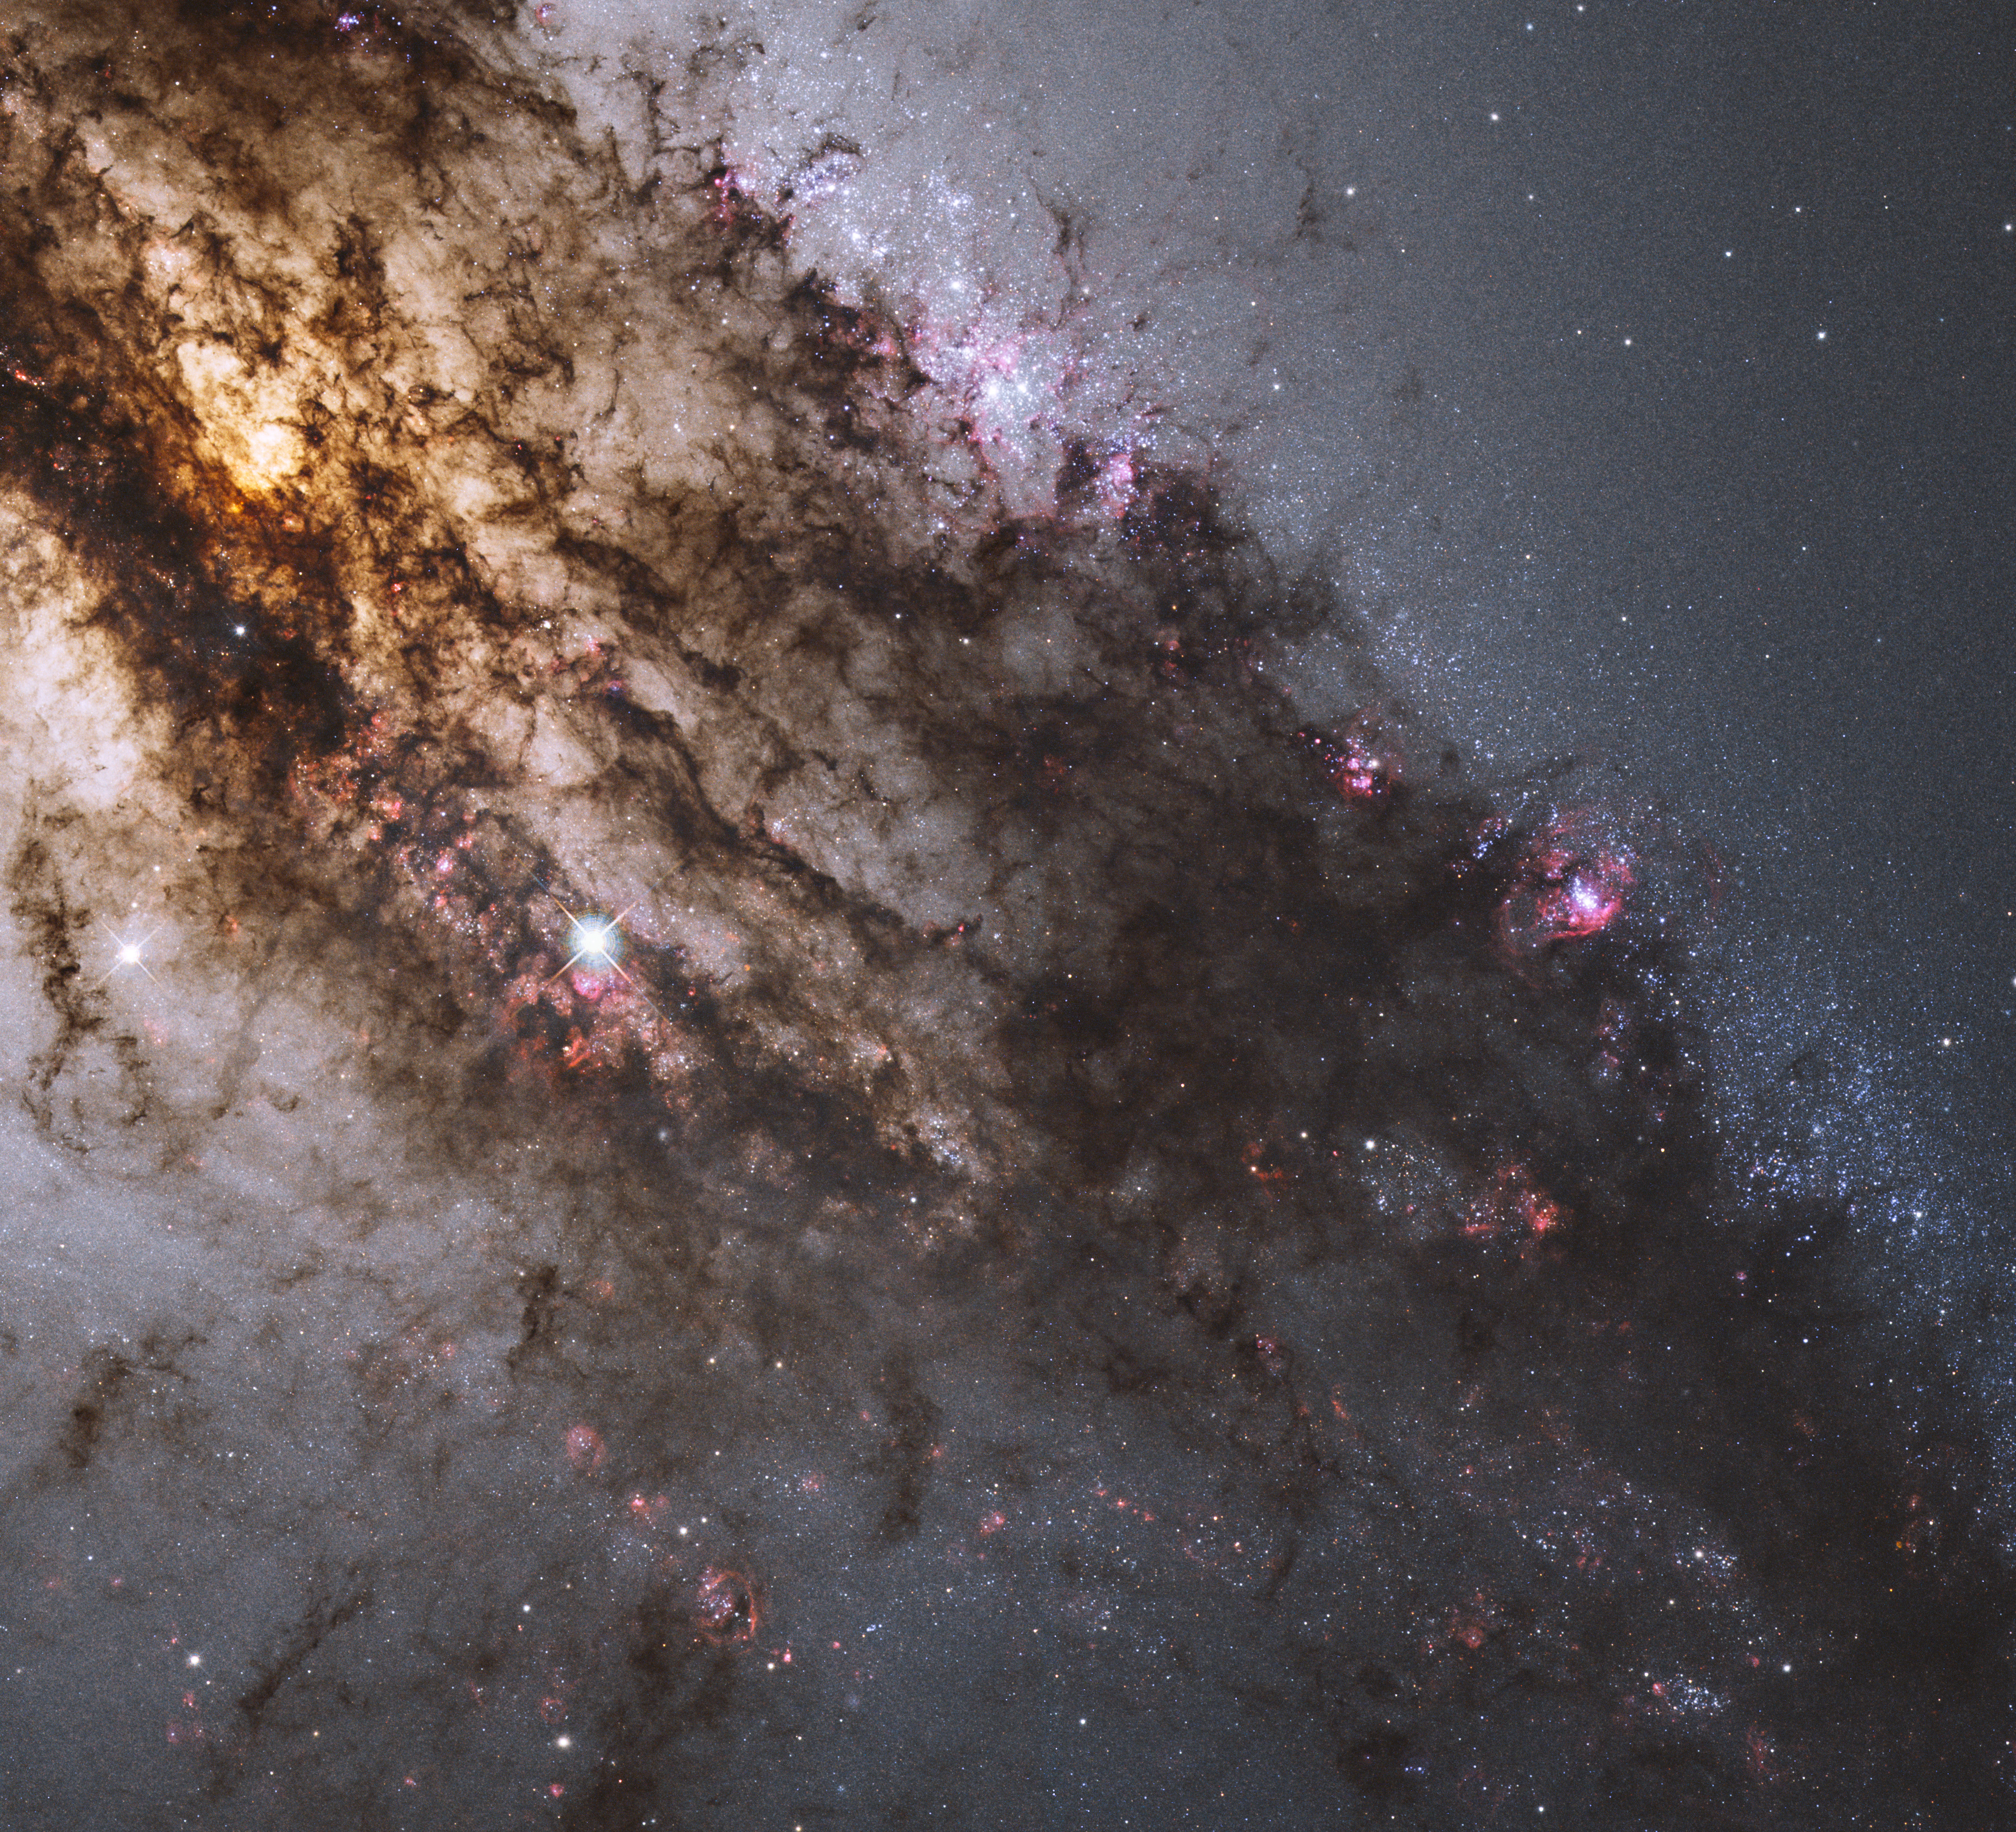
Фантастическая куча молодых голубых звёздных скоплений, гигантские светящиеся газовые облака и тёмные пылевые прожилки окружают центральную область активной галактики Центавр А. Эта фотография, полученная Космическим телескопом имени Хаббла, была обработана так, чтобы показать естественные цвета этого космического вихря. Инфракрасные изображения, также сделанные космическим телескопом, показывают, что в центре этой активной галактики скрывается диск, в котором вещество крутится и падает в чёрную дыру массой в миллиард масс Солнца. Центавр А, вероятно, является результатом столкновения двух галактик. Оставшиеся от столкновения обломки постоянно поглощаются чёрной дырой. Астрономы считают, что центральный механизм, обусловленный наличием чёрной дыры, испускает радиоизлучение, рентгеновские и гамма-лучи, что характерно для Центавра A и других активных галактик. Активная галактика Центавр A находится близко от Земли, на расстоянии 10 миллионов световых лет, и является удобной лабораторией для исследования этих мощных источников энергии.
Вверху и внизу
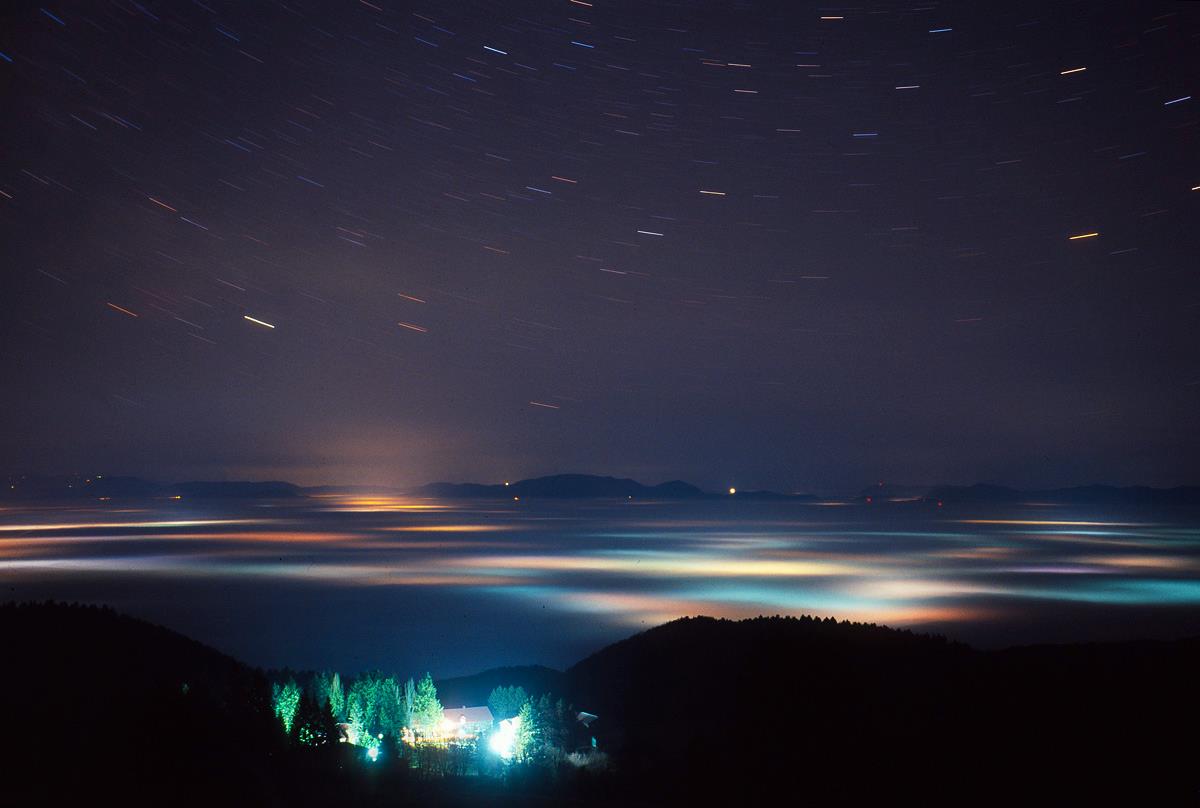
Эти звёздные следы над удивительным цветным морем облаков были сфотографированы с помощью одной длинной экспозиции. Действие происходит в горах Медведница, а облака подсвечиваются снизу огнями северной части Загреба — столицы Хорватии. Небесный северный полюс, находящийся в центре всех цветных звёздных арок, расположился за верхним правым углом фотографии. И хотя на дворе век цифровой аппаратуры, это фото было получено с помощью цветной плёнки и камеры среднего формата. Звёздное небо над эфемерным морем облаков, похожее на сцену из сна, напоминает о тех временах, когда 10 миллионов лет назад эта часть Европы была скрыта Паннонским морем.
Памятное сияние над Норвегией
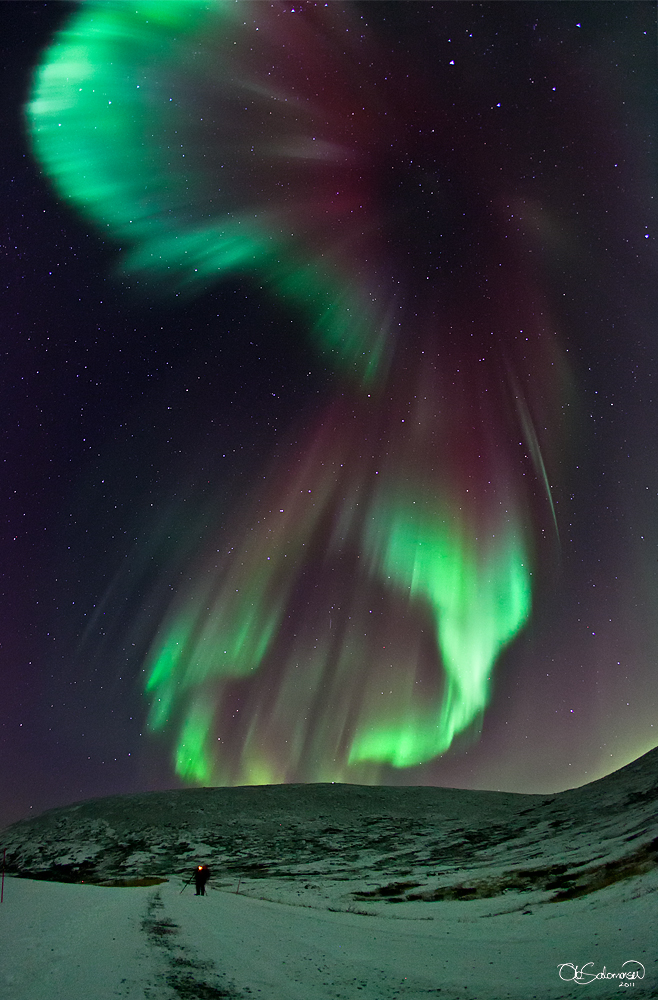
Это было самое запоминающееся полярное сияние в сезоне. Небо переливалось зелёным, красным и каким-то смешанным цветом. были видны многочисленные лучи, занавесы, и даже авроральная корона. Сияние заняло собой почти всё небо. На заднем плане расположились многочисленные звёзды, которые невозможно сосчитать, а на переднем — коллега, пытающийся сфотографировать небесное свечение. Эта сцена была запечатлена с помощью широкоугольного объектива "рыбий глаз" в прошлом месяце в местечке Тромсё в Норвегии. Солнце становится всё более активным, и следующий год принесёт с собой более красочные полярные сияния.
Небесное столкновение
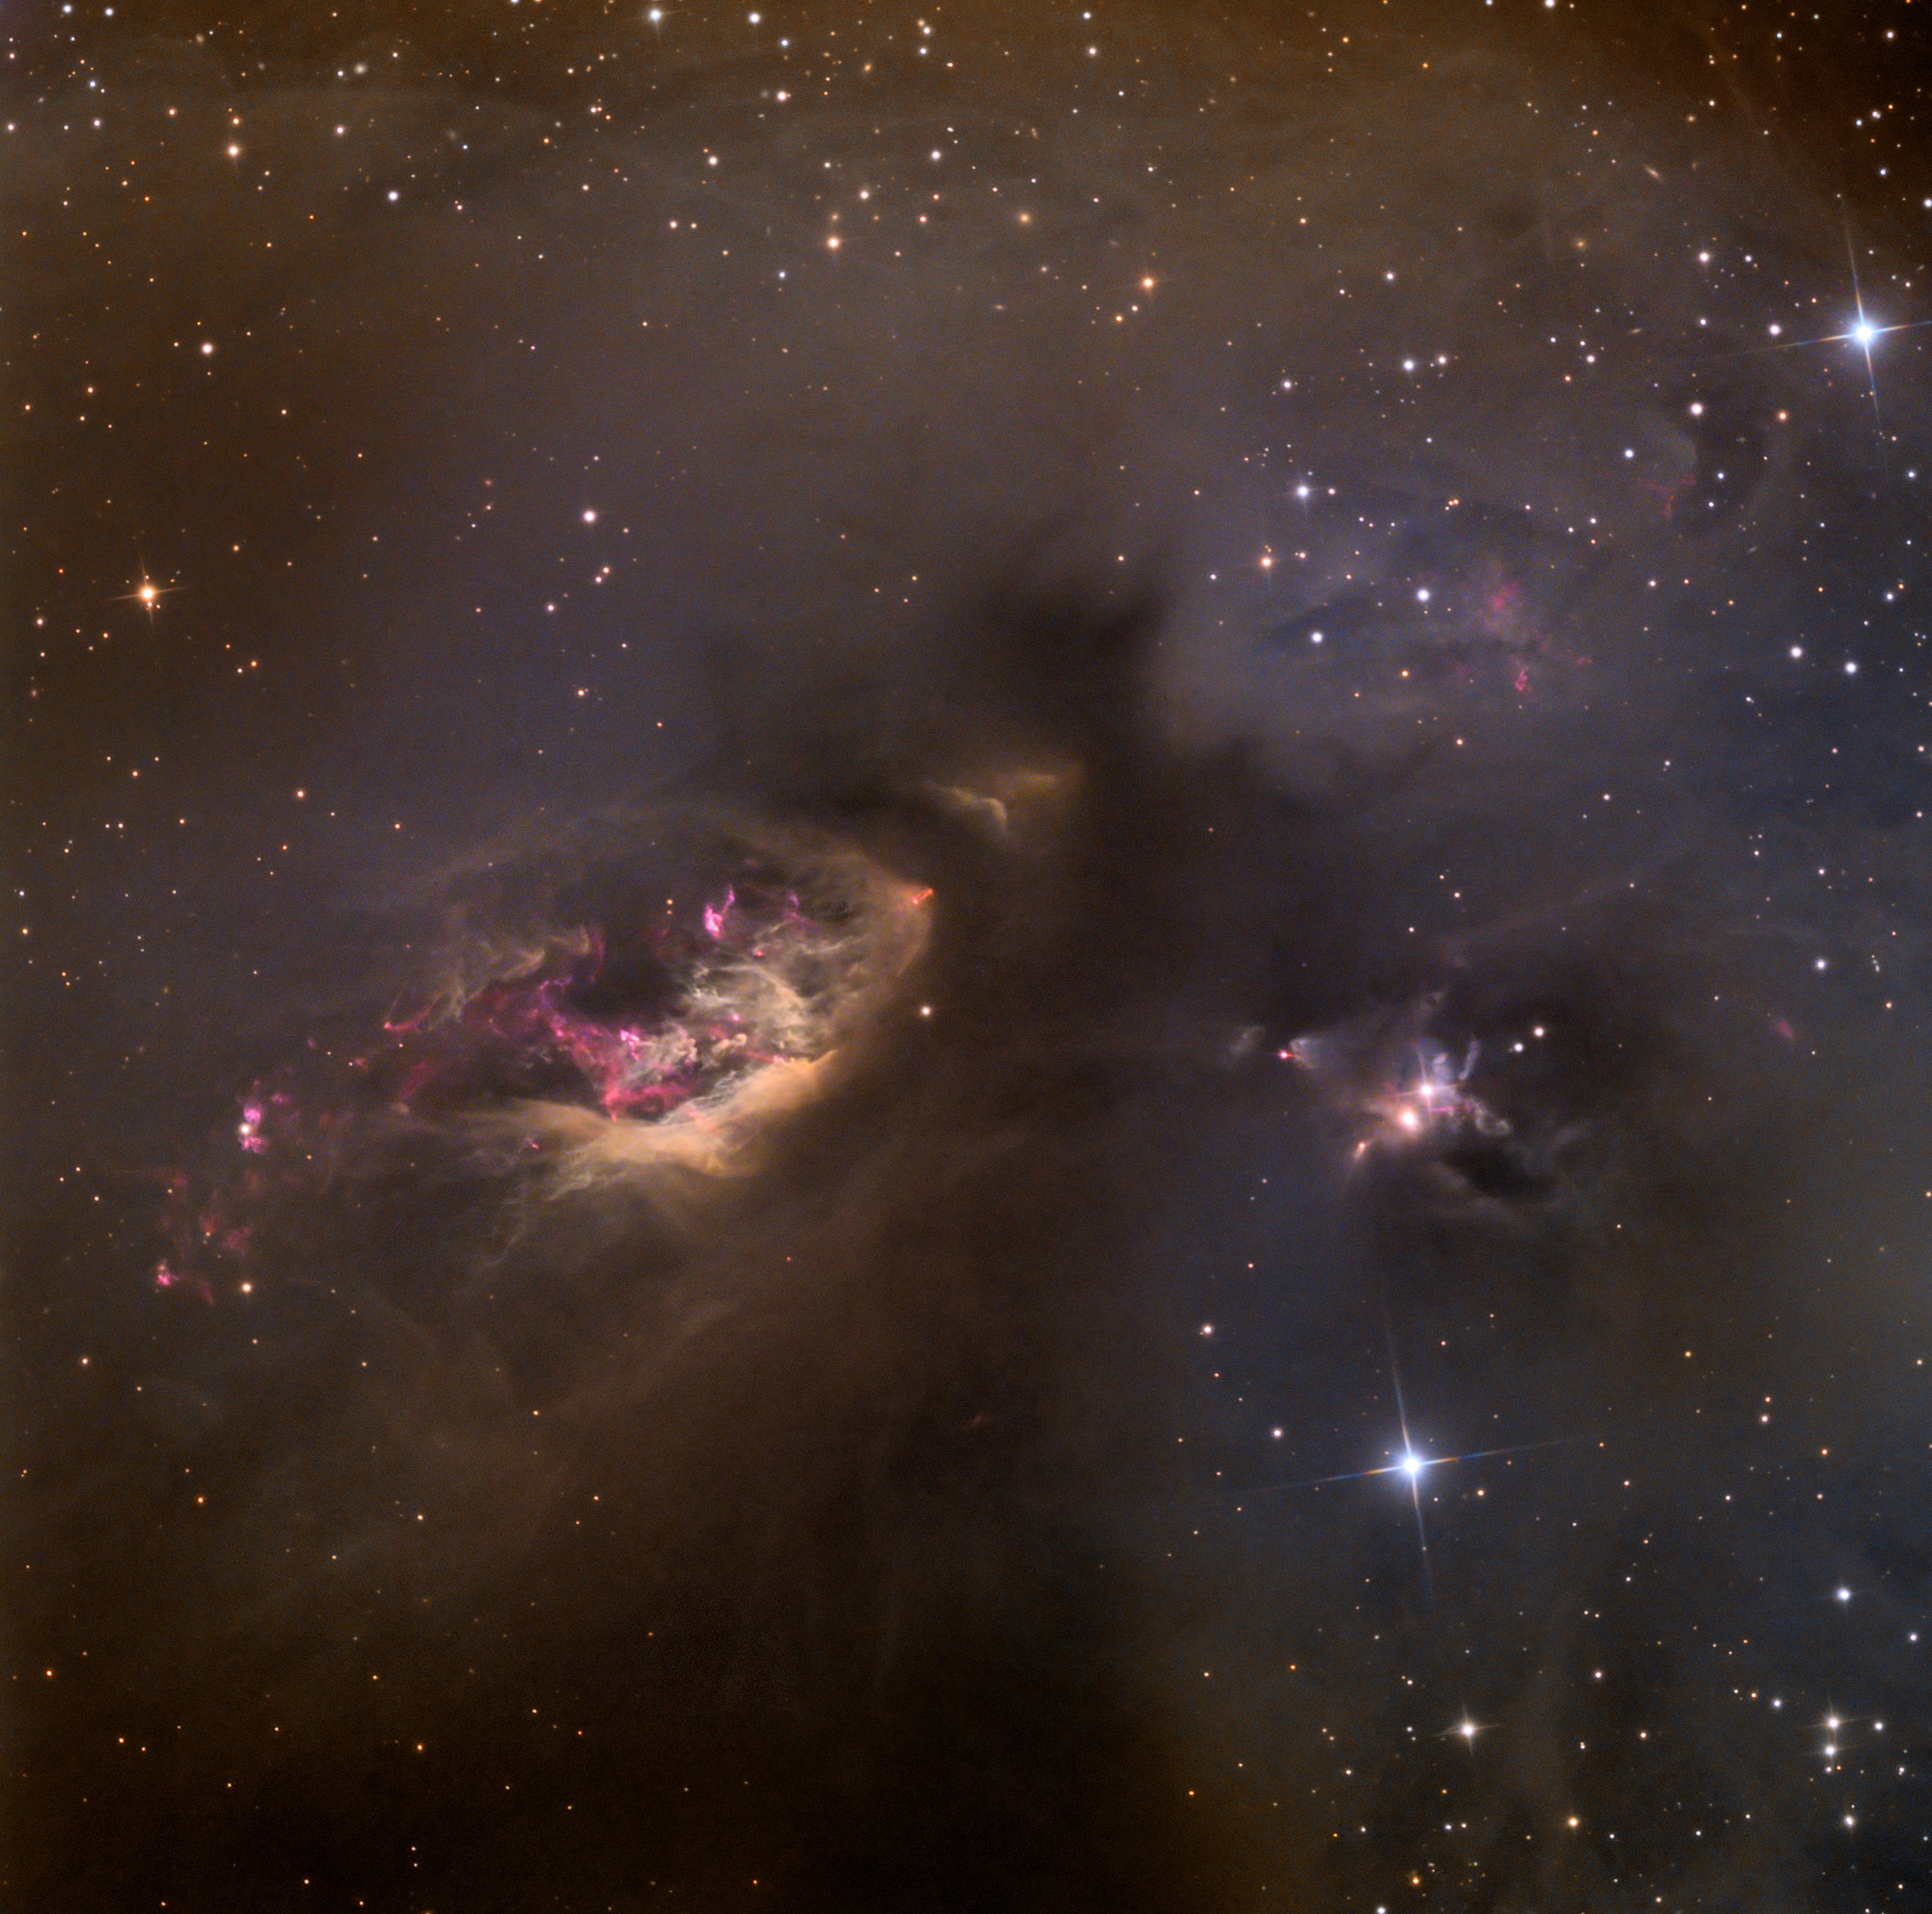
Эту замечательную смесь пыли и темных туманностей создала на небе "космическая кисть" звездообразования. Занесенная в каталоги как Sh2-239 и LDN 1551 область находится около южного конца комплекса молекулярных облаков в Тельце и удалена от нас на 450 световых лет. Это космическое полотно охватывает область размером почти в три световых года, на нем можно найти множество признаков присутствия молодых звездных объектов, выбрасывающих потоки вещества в окружающую среду. Около центра картинки находится компактный красный джет из подвергшегося воздействию ударной волны водорода. Его положение совпадает с инфракрасным источником IRS5, который является системой протозвезд, окруженных пылевыми дисками. Ниже видны более широкие и яркие крылья HH 102, одного из многих объектов Хербига-Аро в данной области. Эти объекты являются туманностями, связанными с недавно родившимися звездами. Оценки показывают, что полное количество вещества в области звездообразования LDN 1551 примерно эквивалентно 50 массам Солнца.
Обнародовано изображение остатков сверхновой Puppis A

Примерно 3,7 тыс. лет назад люди могли заметить в небе новую звезду. Постепенно она тускнела, а потом и вовсе пропала из виду. Только современные астрономы смогли отыскать её остатки — объект Puppis A, удалённый от нас на 7 тыс. световых лет.
НАСА обнародовало изображение этого чуда природы на основании данных инфракрасного космического телескопа WISE. На картинке объект выглядит не столько как остаток взрыва сверхновой, сколько как гигантская космическая роза диаметром в 10 световых лет.
Взрывная волна нагрела облака пыли и газа, окружавшие сверхновую, поэтому их видно в инфракрасном свете. Основная часть материала звезды оказалась выброшена в космос, но всё-таки немного осталось, что сформировало нейтронную звезду RX J0822-4300 — объект с огромной плотностью (на изображении её не видно — слишком тусклая). Она движется со страшной скоростью — около 1,5 млн м/с (относительно окружающих звёзд). Астрономы, озадаченные этим абсурдом, назвали объект космическим пушечным ядром.
Зеленоватые облака пыли и газа на изображении — остатки другой древней сверхновой, объекта Vela. Тот взрыв произошёл где-то 12 тыс. лет назад в четыре раза ближе к Земле, чем Puppis A.
Цвета на снимке представляют различные длины волн в инфракрасной части спектра.
В окрестностях туманности Конус
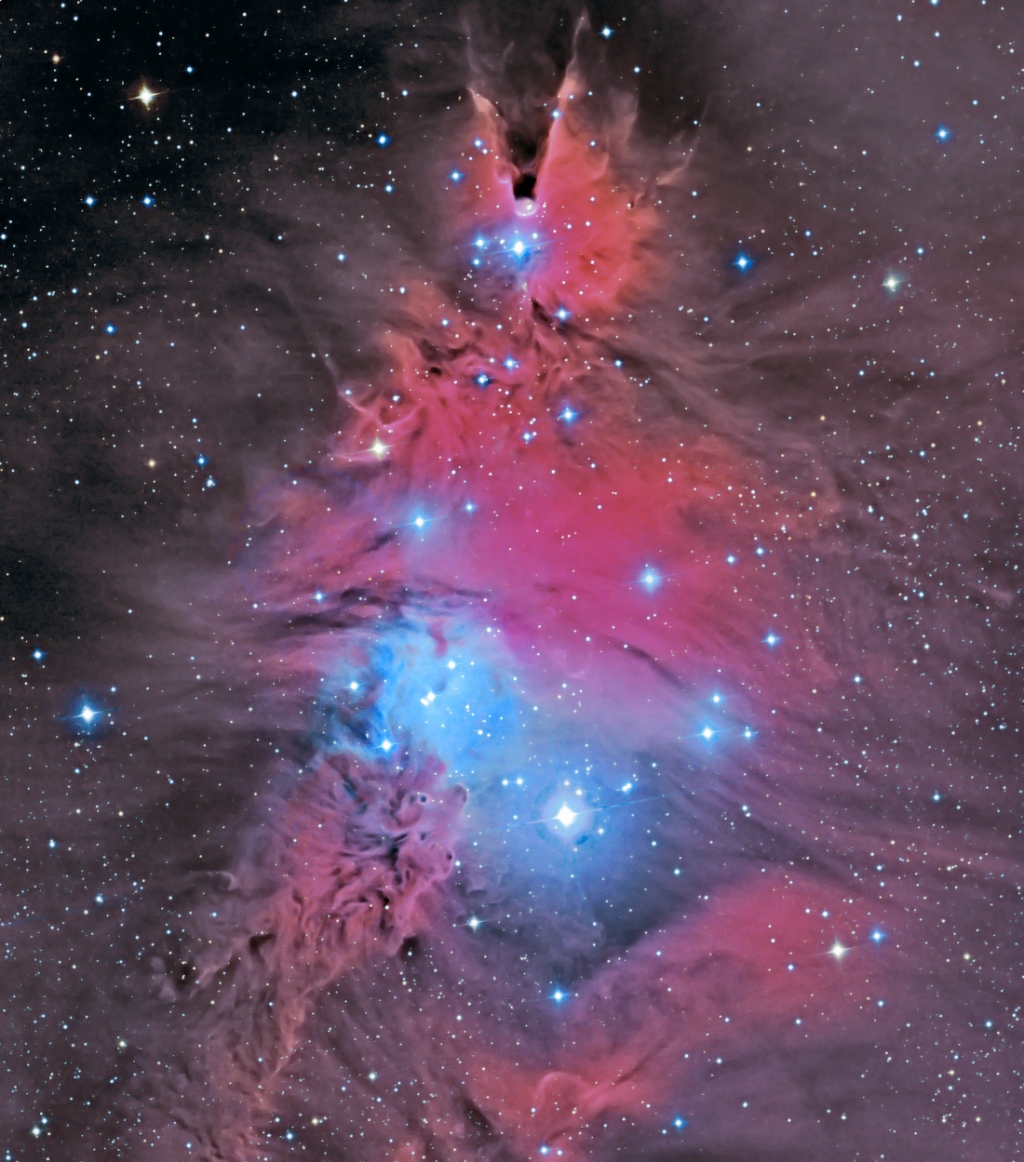
По соседству с туманностью Конус можно обнаружить вещество странных форм и текстур. Такие необычные формы рождаются из лёгкой пыли, которая сложным образом взаимодействует с высокоэнергичным излучением и и горячим газом, испущенным молодыми звёздами. Самая яркая звезда в правой части этой фотографии — это S Единорога, а сразу под ней находится область, названная туманность Лисий мех за свой цвет и структуру. Голубое свечение вокруг звезды S Mon обусловлено отражением её излучения соседствующей межзвёздной пылью. Красное свечение, заполнившее почти всё остальное пространство на картинке, обусловлено не только отражением света от пыли, но и излучением водорода, ионизованного звёздным излучением. Звезда S Mon является частью молодого рассеянного звёздного скопления под названием NGC 2264, расположенного в 2 500 световых лет от нас в направлении на созвездие Единорога. Происхождение таинственной геометрической туманности Конус, видимой слева, пока остаётся загадкой.
Восставшие молодые звезды против родительского облака
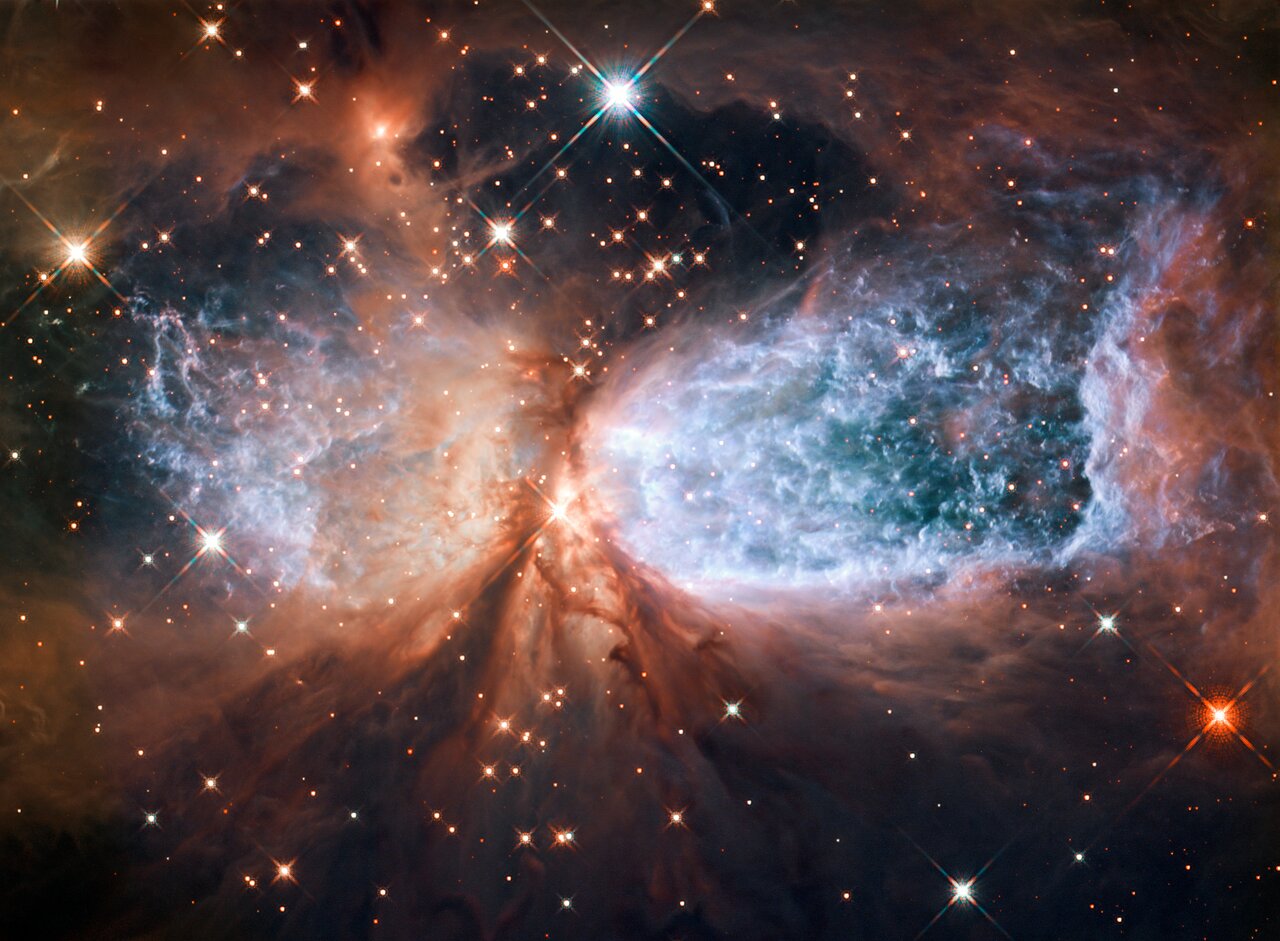
К приближающимся новогодним и рождественским праздникам космический телескоп Hubble сделал людям весьма красивый "подарок", снимок космической туманности, в недрах которой формируется молодая звезда, которая очень похода на фигуру ангела, расправившего свои крылья в космическом пространстве. Эта туманность, называемая Sharples 2-106, сокращенно S106, находится на удалении почти 2000 световых лет по направлению на созвездие Лебедя. Туманность S106 была 106-м объектом, который был внесен в каталог в 1950-х годах астрономом Стюартом Шарплессом (Stewart Sharpless), что и стало основой для ее названия.
Размеры туманности составляют несколько световых лет, она состоит из обширных газовых облаков, которые имеют форму песочных часов или расправленных крыльев. В центре туманности находится массивная молодая звезда, называемая Infrared Source 4 или IRS 4, процесс формирования которой начался относительно недавно. Приблизительно через миллион лет звезда IRS 4 пройдет стадию формирования и вступит в основную фазу цикла жизни звезд. Тогда она будет ярким синим гигантом, перерабатывающим огромные количества водорода в гелий. А смерть этой звезды станет самым разрушительным событием для этой области космоса, которая будет буквально сметена взрывом сверхновой, который затмит даже свет близлежащих галактик.
Сейчас эта звезда излучает мощнейшие потоки инфракрасного и ультрафиолетового излучения, нагревающие близлежащие газовые облака до температуры в 18 тысяч градусов. Именно эти пылающие облака и создают бело-синие "песочные часы" или крылья, как кому будет угодно.
Астрономы детально изучили туманность и обнаружили в ней около 600 маленьких темных коричневых пятен. Оказывается, что эти пятна являются не родившимися звездами, которые стали коричневыми карликами. Эти коричневые карлики имеют массу, равную одной десятой доли массы Солнца, и не имеют достаточно материи и энергии для того, что бы зажечь внутри себя термоядерный "котел".
В космосе найден источник земной воды

Перекись водорода (H2O2) является ключевой молекулой у астрономов и химиков. Она была обнаружена недалеко от звезды Ро Змееносца, это около 400 световых лет от Земли. Область является очень холодной (около -250 градусов по Цельсию), состоящая из плотных облаков космического газа и пыли, в которых рождаются новые звезды. Формирование H2O2 тесно связано с двумя другими знакомыми молекулами, кислорода и воды, которые являются необходимыми для жизни. Сейчас считается, что большая часть воды, находящаяся на нашей планете, изначально формируются в космосе. И ученые стремятся понять, как она создается.
Международная команда астрономов сделала открытие с помощью Atacama Pathfinder Experiment telescope (APEX), находящегося на плато в Андах на высоте 5000 метров от уровня моря.
Облака состоят в основном из водорода, но содержат следы и других химических веществ. Сами же вещества и их соединения являются основными целями в охоте астрономов. Телескопы, такие как APEX, способны регистрировать излучение в миллиметровом и субмиллиметровом диапазоне, что идеально подходит для обнаружения различных соединений и молекул.
Сейчас же команда нашла следы света от излучаемой перекиси водорода в облаках рассматриваемой Ро Змееносца.
Странности карликовых галактик

Карликовая галактика NGC 4214 вся в огне молодых звезд и светящихся газовых облаков. Она расположена примерно в 10 миллионах световых лет от Земли в созвездии Гончих Псов (охотничьих собак) и имеет широкое разнообразие эволюционных этапов среди звезд, что делает её идеальной лабораторией для исследования процессов формирования звезд и их эволюции. Это цветное изображение было получено использованием широкоугольной камерой космического телескопа Хаббла в 3 в декабре 2009 года.
Другая карликовая галактика расположена на расстоянии около 30 миллионов световых лет от Земли. Она подробно предоставила астрономам новый взгляд на то, как образование галактик и черных дыр могли происходить в молодой Вселенной.
IC 1805: туманность Сердце

Что заставляет светиться туманность Сердце? Большая эмиссионная туманность, названная IC 1805, по своему виду очень напоминает человеческое сердце. Ярче всего туманность светится в красной области спектра. Это излучение обусловлено главным элементом в составе туманности — водородом. Свечение всего газового облака подпитывается излучением маленькой группы звёзд, находящихся в центре туманности. На сегодняшней фотографии с высоким динамическим диапазоном (HDR), охватывающей около 30 световых лет, можно увидеть большинство из этих звёзд. В этом рассеянном скоплении есть несколько ярких звёзд с массой в 50 раз больше солнечной, много слабеньких звёздочек, не дотягивающих по массе до Солнца, а ещё там не хватает микроквазара, который был изгнан из скопления гравитационными силами миллионы лет назад. Туманность Сердце расположена на расстоянии около 7 500 световых лет от нас в направлении на созвездие Кассиопеи.
Красная дуга - остатки древней массивной звезды

Изображения, полученные в космической обсерватории Планка, помогают выявить движущие силы формирования звезд и предоставляют астрономам возможность понять сложную физику, формирующую пыль и газ в нашей Галактике. Там, где земные оптические телескопы видят только черное пространство, глаза обсерватории Планка выявляет мириады светящихся структур пыли и газа. Эту способность космической обсерватории астрономы использовали для проверки области Ориона - колыбели новых звёзд, расположенной около 1500 световых лет от Земли.
Изображение охватывает большую часть созвездия Ориона. Туманность — это светлое пятно снизу от центра.
Считается, что гигантские красные дуги петли Барнарда, являются взрывной волной от звезды, которая взорвалась внутри данной области около двух миллионов лет назад. Созданный взрывом пузырь в настоящее время составляет около 300 световых лет в диаметре.


